Offline Polict Learning
Sabato, 17 Ottobre 2026 | Reinforcement Learning |
Nel Reinforcement Learning off-policy o Batch RL, l’agente apprende una policy ottimale utilizzando un insieme di dati preesistenti, senza interagire direttamente con l’ambiente. Si parte da un dataset \( \mathcal{D} \) composto da \( n \) traiettorie \( \tau \sim \pi_b \), raccolte da una behavior policy \( \pi_b \) (ad esempio una policy umana o precedente versione dell’agente). Ogni traiettoria contiene sequenze di stati \( s_t \in \mathcal{S} \), azioni \( a_t \in \mathcal{A} \) e ricompense \( r(s_t, a_t) \).
L’obiettivo è stimare o migliorare una nuova policy \( \pi_t(s_t) \to a_t \) a partire da questi dati, valutando controfattualmente cosa accadrebbe se l’agente agisse in modo diverso. Tuttavia, non è possibile semplicemente applicare il Q-learning tradizionale, poiché, pur essendo un algoritmo off-policy, soffre del cosiddetto “deadly triad” — una combinazione pericolosa di tre fattori:
- Bootstrapping: l’aggiornamento del valore dipende da stime precedenti, amplificando eventuali errori.
- Funzione di approssimazione: l’uso di modelli non lineari (es. reti neurali) introduce instabilità.
- Off-policy learning: l’algoritmo apprende da dati generati da una policy diversa, creando divergenze.
Questa interazione può causare instabilità numeriche e fallimenti nella convergenza. Per questo motivo, le tecniche di Batch RL e Counterfactual RL sviluppano varianti più stabili di apprendimento off-policy, capaci di sfruttare dati raccolti in precedenza senza introdurre bias o divergenze.
Offline policy learning and optimization
Nel contesto del Batch Policy Evaluation, l’obiettivo è stimare le prestazioni di una specifica policy decisionale \( \pi \) utilizzando un dataset preesistente di esperienze raccolte da una behavior policy \( \pi_b \). Questo processo è fondamentale nel Reinforcement Learning off-policy, dove non è possibile (o desiderabile) generare nuove interazioni con l’ambiente.
Model based approach
Data una policy \( \pi: s \to a \) e un insieme di traiettorie \( \mathcal{D} = \{\tau_i\}_{i=1}^n \) campionate da \( \pi_b \), si stima il valore atteso di \( \pi \) integrando la funzione di valore stimata \( \hat{V}^\pi(s, \mathcal{D}) \) sugli stati iniziali \( S_0 \):
\( \int_{s \in S_0} \hat{V}^\pi(s, \mathcal{D}) \, ds \)
In questo modo si ottiene una stima del rendimento della policy \( \pi \) senza eseguirla direttamente nell’ambiente, basandosi solo sui dati storici raccolti. Tale approccio è cruciale per valutare politiche candidate in modo sicuro e controllato, specialmente in domini dove la sperimentazione diretta è costosa o rischiosa (come medicina o robotica).
Nel Batch Reinforcement Learning, è possibile stimare le prestazioni di una policy anche senza accedere direttamente all’ambiente, ricostruendo dai dati sia il modello di dynamics che quello di reward. A partire dal dataset di esperienze \( \mathcal{D} \), si apprende una stima del modello di transizione \( \hat{p}(s'|s, a) \) e della funzione di ricompensa \( \hat{r}(s, a) \).
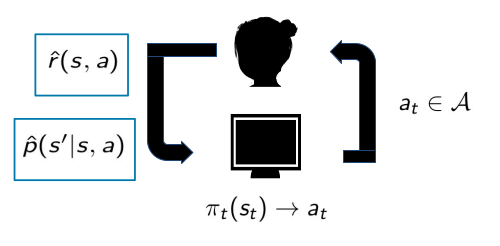
Queste due componenti permettono di derivare una policy stimata \( \hat{\pi}^* \) e di calcolare il valore associato:
\( V^\pi \approx (I - \gamma \hat{P}^\pi)^{-1} \hat{R}^\pi \)
dove \( \hat{P}^\pi(s'|s) = p(s'|s, \pi(s)) \) rappresenta le dinamiche indotte dalla policy, e \( \gamma \) è il fattore di sconto. In alternativa, si può utilizzare il modello appreso per addestrare una nuova policy mediante algoritmi come DQN o altri metodi di RL.
Il valore stimato \( \hat{V}^{\pi^*} \) consente quindi di valutare la policy sulla base del dataset \( \mathcal{D} \), senza ulteriori interazioni con l’ambiente, sfruttando appieno l’informazione implicita nei dati raccolti da una behavior policy precedente.
In pratica si incontra un limite cruciale dell'approccio model-based di dynamics e reward appresi dai dati: anche se un modello risulta accurato nel rappresentare le esperienze passate, potrebbe non generalizzare bene alle situazioni future. Questo fenomeno è noto come bias da errata specificazione del modello (model misspecification). Risultati mostrano che migliorare l’adattamento del modello ai dati osservati non implica necessariamente migliori politiche per scenari futuri. Al contrario, può introdurre distorsioni sistematiche se il modello sottostante è mal specificato.
In sintesi, nella costruzione di modelli per il Reinforcement Learning off-policy o batch, è essenziale bilanciare l’accuratezza rispetto ai dati storici con la capacità di generalizzare a contesti nuovi, evitando che la policy appresa resti vincolata alle limitazioni del modello stesso.
Nel contesto della valutazione off-policy, i modelli utilizzati per stimare le prestazioni di una policy alternativa possono fornire risultati migliori se vengono addestrati con una funzione di perdita diversa da quella usata per la semplice massimizzazione della verosimiglianza. In sintesi, per ottenere una buona valutazione off-policy con un approccio model-based, non basta addestrare modelli accurati sui dati, ma può essere necessario progettare la loss function in funzione del tipo di stima desiderata.
In sintesi, nella costruzione di modelli per il Reinforcement Learning off-policy o batch, è essenziale bilanciare l’accuratezza rispetto ai dati storici con la capacità di generalizzare a contesti nuovi, evitando che la policy appresa resti vincolata alle limitazioni del modello stesso.
Model free methods
L’approccio Model-Free all’apprendimento off-line si basa sulla stima diretta della funzione di valore o della funzione \( Q \), senza la necessità di apprendere un modello esplicito delle dinamiche dell’ambiente. In questo contesto, un metodo molto utilizzato è la Fitted Q Evaluation (FQE), proposta da Ernst et al. (2005).
Si parte da un dataset di esperienze \( \mathcal{D} = \{(s_i, a_i, r_i, s_{i+1})\}_i \), generato da una behavior policy \( \pi_b \). L’obiettivo è stimare la funzione di valore d’azione della policy da valutare \( Q^\pi_\theta(s, a) \).
Per ogni transizione, viene costruito un target supervisionato:
\( \tilde{Q}^\pi(s_i, a_i) = r_i + \gamma V^\pi_\theta(s_{i+1}) \)
Il modello viene quindi aggiornato minimizzando l’errore quadratico medio tra il valore stimato e il target:
\( \arg\min_\theta \sum_i \left(Q^\pi_\theta(s_i, a_i) - \tilde{Q}^\pi(s_i, a_i)\right)^2 \)
Iterando questo processo, si ottiene una stima stabile della funzione \( Q^\pi \) che approssima il valore d’azione per la policy in esame, sfruttando solo i dati già raccolti (off-line). Tra le varianti correlate figurano anche i metodi LSTD (Least Squares Temporal Difference) e le tecniche di regressione iterativa applicate alle funzioni di valore.
In sintesi, l’approccio model-free consente di valutare e migliorare le policy direttamente dai dati, evitando gli errori di modellazione tipici dei metodi model-based, ma richiede una buona copertura dello spazio di stati e azioni nel dataset per garantire stime affidabili.
L’algoritmo di Fitted Q Evaluation (FQE) consente di stimare la funzione di valore d’azione di una policy \( \pi \) utilizzando un dataset statico di transizioni, senza interagire con l’ambiente. È un metodo chiave nell’apprendimento off-line model-free.
Input:
- \( \mathcal{D} = \{(x_i, a_i, x'_i, c_i)\}_{i=1}^n \sim \pi_D \): dataset di transizioni;
- \( \pi \): policy da valutare;
- \( \mathcal{F} \): classe di funzioni (ad esempio una rete neurale profonda).
Algoritmo:
- 1. Inizializza \( Q_0 \in \mathcal{F} \) casualmente.
- 2. Per \( k = 1, 2, \ldots, K \):
- 3. Calcola il target: \( y_i = c_i + \gamma Q_{k-1}(x'_i, \pi(x'_i)) \quad \forall i \)
- 4. Costruisci il set di addestramento: \( \tilde{\mathcal{D}}_k = \{(x_i, a_i, y_i)\}_{i=1}^n \)
- 5. Risolvi un problema di apprendimento supervisionato:
- \( Q_k = \arg\min_{f \in \mathcal{F}} \frac{1}{n} \sum_{i=1}^n (f(x_i, a_i) - y_i)^2 \)
- 6. Fine ciclo.
Output:
\( \hat{Q}^\pi(x) = Q_K(x, \pi(x)) \quad \forall x \)
In pratica, FQE addestra iterativamente una funzione \( Q \) fino alla convergenza, stimando il valore della policy target sui dati raccolti da un’altra policy (behavior policy).
Se si utilizza una DNN come classe di funzioni \( \mathcal{F} \), l’algoritmo diventa analogo al DQN, ma con una differenza cruciale: FQE non interagisce con l’ambiente e aggiorna solo in base ai dati esistenti, mentre DQN genera nuovi campioni online durante l’apprendimento.
La teoria di generalizzazione della Fitted Q Evaluation (FQE) fornisce una stima della quantità di dati necessaria per garantire che la valutazione della policy sia accurata con alta probabilità. In particolare si stabilisce che, dopo \( K \) iterazioni di FQE, la precisione dell’approssimazione dipende dalla numerosità del dataset \( n \).
La condizione sulla dimensione campionaria è:
\( n = O\!\left(\frac{\bar{C}^4}{\varepsilon^2}\!\left(\log\frac{K}{\delta} + \dim\mathcal{F}\log\frac{\bar{C}^2}{\varepsilon^2} + \log\dim\mathcal{F}\right)\right) \)
Il termine \( n \) rappresenta quindi il numero minimo di transizioni necessarie per assicurare, con probabilità almeno \( 1 - \delta \), che la differenza tra il valore stimato \( \hat{V}^\pi(s_0) \) e quello reale \( V^\pi(s_0) \) rimanga entro un margine controllato da \( \varepsilon \).
In termini pratici:
- \( \varepsilon \) indica il livello di accuratezza desiderato — minore è \( \varepsilon \), maggiore deve essere \( n \);
- \( \delta \) controlla la probabilità di errore nella stima (livello di confidenza);
- \( \dim\mathcal{F} \) rappresenta la complessità del modello di apprendimento (ad esempio, la dimensione della rete neurale);
- \( \bar{C} \) e \( d_{\mathcal{F}}^{\pi} \) misurano rispettivamente la stabilità e la capacità di concentrazione della funzione \( Q \) nel dominio della policy target.
In sintesi, il teorema fornisce una garanzia formale sulla generalizzazione della stima ottenuta da FQE: per raggiungere una data precisione \( \varepsilon \) nella valutazione di \( V^\pi \), è necessario un dataset di dimensione \( n \) proporzionale a \( 1 / \varepsilon^2 \) e alla complessità della funzione stimata.
Importance sampling
L’Off-Policy Evaluation (OPE) mira a stimare il valore di una policy target utilizzando dati raccolti da un’altra policy, detta behavior policy, riducendo al minimo le assunzioni sul modello dell’ambiente. L’obiettivo è ottenere una stima affidabile senza dipendere dalla correttezza del modello dinamico né dall’ipotesi di Markov.
In questo contesto, i metodi Monte Carlo rappresentano un punto di partenza utile: essi consentono di stimare aspettative basandosi su campioni empirici, come già avviene per la valutazione online delle policy. Tuttavia, la sfida principale nel caso off-policy è il mismatch di distribuzione dei dati: i dati raccolti dalla policy comportamentale non riflettono necessariamente la distribuzione indotta dalla policy target.
Per affrontare questo problema si utilizza la Importance Sampling (IS), una tecnica statistica che permette di correggere la differenza tra le due distribuzioni tramite un fattore di ponderazione.
L’idea è stimare l’aspettativa di una quantità \( r(x) \) sotto la distribuzione desiderata \( p(x) \) utilizzando campioni estratti da una distribuzione diversa \( q(x) \):
\( \mathbb{E}_p[r] = \sum_x p(x) r(x) = \sum_x q(x) \frac{p(x)}{q(x)} r(x) \approx \frac{1}{N} \sum_{i=1}^N \frac{p(x_i)}{q(x_i)} r(x_i) \)
In questo modo, ogni campione \( x_i \) è pesato in base al rapporto tra la probabilità di osservazione sotto la distribuzione target e quella sotto la distribuzione di comportamento. Questo consente di ottenere una stima non distorta dell’aspettativa reale, a condizione che:
- la distribuzione di campionamento \( q(x) \) copra tutte le regioni dove \( p(x) > 0 \) (proprietà di coverage/overlap);
- non vi siano variabili confondenti nascoste che alterano la relazione tra \( x \), le azioni \( a \) e le ricompense \( r \).
L’Importance Sampling per la valutazione di policy in Reinforcement Learning permette di stimare il valore atteso di una policy target \( \pi \) senza dover conoscere il modello dinamico dell’ambiente. L’idea centrale è riutilizzare traiettorie raccolte da una behavior policy \( \pi_b \), correggendo la differenza di distribuzione tramite pesi di probabilità.
Il valore della policy target è definito come:
\( V^{\pi}(s) = \sum_{\tau} p(\tau \mid \pi, s) R(\tau) \)
Poiché le traiettorie disponibili provengono da \( \pi_b \), possiamo riscrivere:
\( V^{\pi}(s) = \sum_{\tau} p(\tau \mid \pi_b, s) \frac{p(\tau \mid \pi, s)}{p(\tau \mid \pi_b, s)} R_\tau \)
e stimarlo empiricamente con:
\( V^{\pi}(s) \approx \frac{1}{N} \sum_{i=1}^{N} \frac{p(\tau_i \mid \pi, s)}{p(\tau_i \mid \pi_b, s)} R_{\tau_i} \)
Poiché le dinamiche dell’ambiente si annullano nel rapporto, i pesi si riducono ai soli rapporti tra probabilità di azioni sotto le due policy:
\( \frac{p(\tau_i \mid \pi, s)}{p(\tau_i \mid \pi_b, s)} = \prod_{t=1}^{H_i} \frac{p(a_{it} \mid s_{it}, \pi)}{p(a_{it} \mid s_{it}, \pi_b)} \)
Quindi, la stima finale del valore atteso della policy target diventa:
\( V^{\pi}(s) \approx \sum_{i=1}^{N} R_{\tau_i} \prod_{t=1}^{H_i} \frac{p(a_{it} \mid s_{it}, \pi)}{p(a_{it} \mid s_{it}, \pi_b)} \)
In sintesi, l’importance sampling in RL consente di valutare una policy senza conoscere le transizioni \( p(s' \mid s, a) \), basandosi solo sui rapporti di probabilità delle azioni tra policy target e behavior policy. Questo approccio è quindi model-free e particolarmente utile in contesti off-policy, dove l’interazione diretta con l’ambiente non è possibile. Questo approccio pertanto non richiede l'assunzione di Markov, è unbiased, simile all'approccio Monte Carlo ma con la correzione del mismatch tra le distribuzioni.
Il Per-Decision Importance Sampling (PDIS) è una variante dell’importance sampling progettata per la valutazione di policy in Reinforcement Learning, che sfrutta la struttura temporale delle traiettorie per ridurre la varianza della stima. L’idea di base è simile a quella dei policy gradient methods: invece di pesare un’intera traiettoria con un unico fattore di probabilità cumulativo, PDIS applica una correzione passo per passo.
La stima classica dell’importance sampling sull’intero dataset \( D \) è data da:
\( IS(D) = \frac{1}{n} \sum_{i=1}^{n} \left( \prod_{t=1}^{L} \frac{\pi_e(a_t \mid s_t)}{\pi_b(a_t \mid s_t)} \right) \left( \sum_{t=1}^{L} \gamma^t R_t^i \right) \)
dove ogni traiettoria è ponderata in base al prodotto dei rapporti di probabilità tra la policy target \( \pi_e \) (evaluation policy) e la policy comportamentale \( \pi_b \) lungo tutti i passi temporali \( t \).
Il Per-State Importance Sampling (PSIS o PDIS) migliora questa formulazione pesando le ricompense parziali passo per passo:
\( PSID(D) = \sum_{t=1}^{L} \gamma^t \frac{1}{n} \sum_{i=1}^{n} \left( \prod_{\tau=1}^{t} \frac{\pi_e(a_\tau \mid s_\tau)}{\pi_b(a_\tau \mid s_\tau)} \right) R_t^i \)
In questo modo, la correzione di importanza viene applicata fino al tempo \( t \) invece che su tutta la traiettoria, permettendo di:
- sfruttare la struttura temporale del dominio (le ricompense dipendono dal tempo);
- ridurre la varianza della stima, particolarmente elevata nel caso standard di IS cumulativo;
- ottenere stime più stabili e più simili a quelle basate su metodi Monte Carlo passo per passo.
Il PDIS rappresenta quindi un compromesso efficace tra accuratezza e stabilità statistica, mantenendo la proprietà di non distorsione dell’IS, ma migliorando la sua efficienza pratica nel contesto di policy evaluation off-policy.
In generale IS e PSID soffrono di alta varianza, specie con orizzonti lunghi, per cui possono essere adottate misure per contrastare il fenomeno, esplicitando l'assunzione di Markov od utilizzando correttivi.
Off-Policy Optimization
Fino al 2020, la Offline Policy Optimization (OPO) — ovvero l’ottimizzazione di policy in ambienti offline — si è basata su un presupposto cruciale: la presenza di overlap tra le distribuzioni delle policy. Questo significa che, nei dataset di esperienza utilizzati per l’addestramento, ogni azione considerata dalla policy target deve essere stata osservata almeno in alcune circostanze dalla policy comportamentale.
In particolare:
- Off-policy estimation: richiede overlap per la sola policy di interesse, al fine di stimarne correttamente il valore atteso.
- Off-policy optimization: richiede overlap per tutte le policy potenzialmente ottimali, ipotesi nota come concentrability assumption nel contesto del batch reinforcement learning.
Tuttavia, questo presupposto è poco realistico in molti scenari pratici. Gran parte dei dataset reali non deriva da esplorazioni casuali o complete dello spazio di stati e azioni: spesso i dati riflettono soltanto le decisioni prese da un singolo sistema o esperto.
Quando si assume overlap dove in realtà non esiste, si rischia di:
- stimare in modo eccessivamente ottimistico le prestazioni di una policy;
- ottenere un comportamento che appare performante in fase di addestramento, ma che fallisce una volta implementato nel mondo reale.
In sintesi, la ricerca successiva ha riconosciuto che la mancanza di overlap rappresenta uno dei principali ostacoli alla robustezza e generalizzazione delle policy apprese in contesti di offline reinforcement learning.
La Off-Policy Optimization senza piena copertura dei dati rappresenta un’evoluzione del Reinforcement Learning offline, nata per affrontare la mancanza di overlap tra le distribuzioni di comportamento e quelle target. Quando il dataset non copre l’intero spazio di stati e azioni, le stime di valore possono diventare instabili o fuorvianti. L’obiettivo è quindi “fare il meglio possibile con i dati disponibili”.
Le strategie principali adottate sono:
- Limitare l’ottimizzazione off-policy solo alle regioni dello spazio \( (s, a) \) dove esiste effettivo overlap nei dati. Questa idea richiama tecniche già note come i vincoli KL e il PPO clipping, che impediscono deviazioni eccessive dalla policy di riferimento.
- Adottare algoritmi computazionalmente trattabili, che possano stimare e penalizzare le regioni scarsamente supportate senza introdurre complessità eccessiva.
- Applicare un approccio pessimistico nelle aree con scarso supporto: in assenza di dati sufficienti, si assume che gli esiti possano essere sfavorevoli, riducendo così il rischio di sovrastimare il valore atteso di certe azioni.
Questa linea di ricerca mira a fornire una risposta al problema del data coverage limitato nell’apprendimento da dati offline.
Il metodo Marginalized Behavior Supported (MBI) Policy Optimization introduce una strategia per gestire l’ottimizzazione di policy in contesti offline dove il supporto dei dati è limitato. L’idea chiave è quella di considerare solo le azioni che hanno una sufficiente probabilità di essere state osservate nella policy comportamentale, evitando di stimare valori in regioni dello spazio \( (s, a) \) scarsamente rappresentate.
Il meccanismo si basa su una filtrazione comportamentale espressa tramite una funzione indicatrice:
\( \zeta(s, a; \hat{\mu}, b) = 1(\hat{\mu}(s, a) > b) \)
dove:
- \( \hat{\mu}(s, a) \) rappresenta la probabilità stimata che l’azione \( a \) sia stata scelta nello stato \( s \) secondo la policy comportamentale;
- \( b \) è una soglia di confidenza che determina il livello minimo di supporto richiesto per considerare l’azione affidabile.
Questa funzione filtra le azioni poco rappresentate, garantendo che le valutazioni si basino solo su esperienze realmente supportate dai dati.
Sulla base di questo filtro, vengono definite due versioni modificate dell’operatore di Bellman:
- Bellman operator:
\( \mathcal{T}f(s,a) = r(s,a) + \gamma \, \mathbb{E}_{s'}\left[\max_{a'} \zeta(s', a') f(s', a')\right] \)
- Bellman evaluation operator:
\( \mathcal{T}^{\pi}f(s,a) = r(s,a) + \gamma \, \mathbb{E}_{s',a' \sim P,\pi}\left[\zeta(s', a') f(s', a')\right] \)
In queste formulazioni, l’operatore \( \zeta(s', a') \) agisce come un filtro che riduce o annulla il contributo delle coppie stato–azione non sufficientemente supportate. Questo approccio permette di mantenere stabilità e coerenza nelle stime del valore, migliorando la robustezza delle policy apprese in scenari con dati parziali o distribuzioni comportamentali sbilanciate.
