GPT-5: uno step verso un'AI più completa
Giovedì, 7 Agosto 2025. OpenAI ha reso disponibile GPT-5, evoluzione e integrazione tra i modelli GPT-Series e o-Series. È progettato per gestire compiti complessi mediante un’architettura modulare costituita da due componenti principali: uno ottimizzato per risposte rapide (fast), e un modulo dedicato al ragionamento elaborato (thinking). Un router in tempo reale seleziona quale modulo attivare in funzione della complessità del prompt, del comportamento dell’utente e della correttezza delle risposte. Questo router si adatta dinamicamente, apprende da dati sulle preferenze e migliora decisio...
OpenAI rilascia i modelli GPT-OSS: disponibili due LLM open-weight da 20B e 120B parametri
Mercoledì, 6 Agosto 2025. OpenAI ha annunciato ( https://openai.com/it-IT/index/introducing-gpt-oss/ ) la disponibilità di due nuovi modelli linguistici di grandi dimensioni (LLM) denominati GPT-OSS, resi pubblici con pesi open-weight e licenza Apache 2.0. Si tratta dei primi modelli di questo tipo pubblicati da OpenAI dall’epoca di GPT-2. I modelli rilasciati sono: gpt-oss-120b – un modello con 120 miliardi di parametri gpt-oss-20b – un modello con 20 miliardi di parametri Entrambi sono disponibili per il download e l'esecuzione locale, con piena compatibilit&...
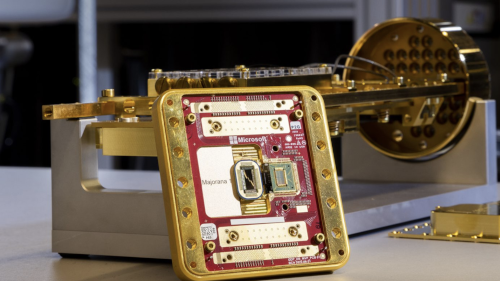
Microsoft presenta Majorana 1: il primo processore quantistico al mondo basato su qubit topologici
Venerdì, 21 Febbraio 2025. Microsoft ha annunciato Majorana 1, un Quantum Processing Unit (QPU) che rappresenta un importante passo avanti nel percorso verso il calcolo quantistico pratico. La particolarità di questo processore risiede nell’uso di qubit topologici, una tecnologia che garantisce maggiore stabilità e riduce gli errori, grazie a un’architettura intrinsecamente protetta. Majorana 1 è progettato per scalare fino a un milione di qubit su un singolo chip, aprendo nuove prospettive per lo sviluppo di computer quantistici in grado di affrontare problemi complessi oggi irrisolvibi...
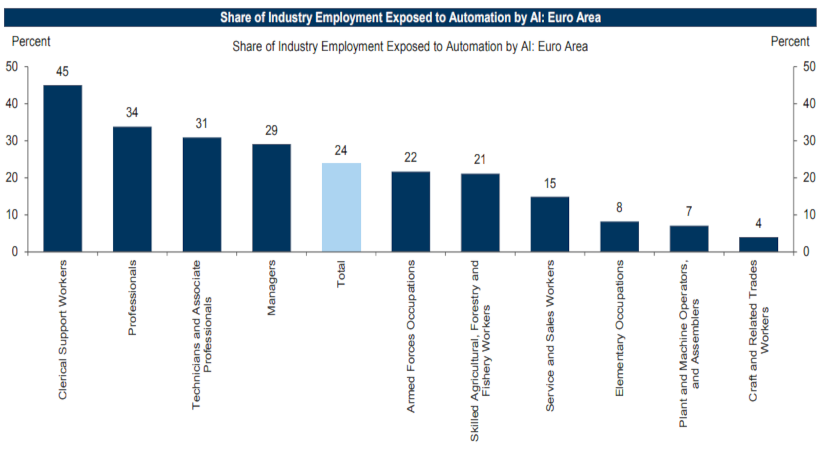
L'IA generativa rivoluziona la crescita economica globale e il mercato del lavoro
Giovedì, 30 Marzo 2023. Un recente studio di Goldman Sachs, "The Potentially Large Effects of Artificial Intelligence on Economic Growth" (Briggs, Kodnani et al.), esamina gli effetti potenzialmente significativi dell'intelligenza artificiale (IA) generativa sulla crescita economica. L'IA generativa, caratterizzata dall'uso generalizzato, dalla capacità di generare contenuti simili a quelli umani e dalle interfacce intuitive, potrebbe cambiare radicalmente il mercato del lavoro e aumentare la produttività a livello globale. Le tecnologie IA generative, come ChatGPT, DALL-E ...
Plug-in per ChatGPT: nuove capacità e accesso real time al web
Mercoledì, 29 Marzo 2023. OpenAI ha lanciato il supporto ai plug-in per ChatGPT, consentendo l'ampliamento delle capacità del chatbot e permettendogli, per la prima volta, di accedere a dati in tempo reale dal web. Fino ad ora, ChatGPT era limitato dall'impossibilità di attingere a informazioni al di fuori del dataset di addestramento, fermo a più di un anno fa. OpenAI afferma che i plug-in permetteranno al bot di interagire con siti web specifici, trasformando potenzialmente il sistema in un'interfaccia per vari servizi. In un video dimostrativo, un utente utilizza ChatGPT per tr...
La rivoluzione AI e la corsa dei colossi della tecnologia
Martedì, 28 Marzo 2023. In una call su Microsoft Teams, Jared Spataro, responsabile del software di produttività di Microsoft, dimostra come l'intelligenza artificiale (AI) riesca ad elaborare un riassunto accurato della conversazione in corso, praticamente in tempo reale. Microsoft sta implementando l'intelligenza artificiale in quasi tutti i suoi prodotti e in particolare nella suite Microsoft 365 attraverso Copilot, appoggiandosi su ChatGPT. Alphabet, la casa madre di Google, sta seguendo la stessa strada con prodotti come Gmail e Sheets. Negli ultimi mesi, anche gli altri giganti della tecnologi...
Multi-Armed Bandit (MAB)
Domenica, 25 Ottobre 2026 | Reinforcement Learning |
Il problema dei multi-armed bandits rappresenta una delle formulazioni fondamentali del reinforcement learning, in cui un agente deve scegliere tra diverse azioni, dette “braccia” (arms), per massimizzare la ricompensa cumulata nel tempo. Formalmente, un bandit è descritto da una coppia \((\mathcal{A}, \mathcal{R})\), dove:
- \(\mathcal{A}\) è l’insieme noto di \(m\) azioni possibili;
- \(\mathcal{R}^a(r) = \mathbb{P}[r \mid a]\) rappresenta la distribuzione di probabilità, sconosciuta, dei reward associati a ciascuna azione.
A ogni passo temporale \(t\), l’agente seleziona un’azione \(a_t \in \mathcal{A}\) e riceve una ricompensa \(r_t \sim \mathcal{R}^{a_t}\) generato dall’ambiente. L’obiettivo dell’agente è massimizzare la ricompensa cumulata nel tempo, cioè: \(\sum_{\tau=1}^{t} r_\tau\). Questo scenario illustra in modo semplice ma potente il compromesso fondamentale del reinforcement learning tra esplorazione (scoprire nuove azioni potenzialmente migliori) ed exploitation (sfruttare le azioni già note come vantaggiose).
Algoritmo Greedy
L’algoritmo greedy rappresenta una strategia fondamentale nei problemi di multi-armed bandit, basata sulla scelta dell’azione con il valore stimato più alto in ogni passo temporale. Gli algoritmi di questo tipo stimano il valore atteso di ciascuna azione \(a\) come: \(\hat{Q}_t(a) \approx Q(a) = \mathbb{E}[R(a)]\), dove \(\mathbb{E}[R(a)]\) è la ricompensa media attesa associata a quell’azione.
Il valore di ogni azione viene calcolato tramite una stima Monte Carlo: \[ \hat{Q}_t(a) = \frac{1}{N_t(a)} \sum_{i=1}^{t-1} r_i \, \mathbf{1}(a_i = a) \] dove \(N_t(a)\) è il numero di volte in cui l’azione \(a\) è stata selezionata fino al tempo \(t\), e \(r_i\) rappresenta la ricompensa osservata.
Il principio greedy consiste quindi nel selezionare, a ogni iterazione, l’azione con il valore stimato più alto: \[ a_t^* = \arg\max_{a \in \mathcal{A}} \hat{Q}_t(a) \] Questa strategia massimizza l’utilizzo delle informazioni note (exploitation), ma ignora la possibilità di esplorare nuove azioni che potrebbero portare a ricompense migliori in futuro. Di conseguenza, l’algoritmo greedy può convergere rapidamente, ma rischia di rimanere bloccato in soluzioni subottimali.
Regret e valutazione dei MAB
Nel contesto dei multi-armed bandits, la quantità di regret è una misura strutturata delle performance dell’agente, che quantifica quanto lo stesso avrebbe potuto guadagnare se avesse sempre scelto l’azione ottimale.
Si definisce infatti il valore ottimale \(V^* = \max_{a \in \mathcal{A}} Q(a)\), dove \(Q(a) = \mathbb{E}[r\mid a]\) è il valore atteso dell’azione \(a\).
Per ogni passo \(t\), il regret istantaneo è dato da \(l_t = \mathbb{E}\big[V^* - Q(a_t)\big]\), mentre il regret cumulato fino al tempo \(t\) è \(L_t = \mathbb{E}\big[\sum_{\tau=1}^t \big(V^* - Q(a_\tau)\big)\big]\).
Minimizzare il regret cumulato equivale, in uno scenario di bandit, a massimizzare la ricompensa cumulativa, e pertanto l’analisi del regret fornisce un criterio formale per valutare e confrontare algoritmi in termini di efficienza e rapidità di apprendimento.
La valutazione del regret nei problemi di multi-armed bandit consente quindi di quantificare come la politica di selezione delle azioni si discosti da quella ottimale.
Per ogni azione \(a\) si definisce \(N_t(a)\) come il numero di volte in cui l’azione è stata selezionata fino al tempo \(t\), e si introduce il gap \(\Delta_a = V^* - Q(a)\), ossia la differenza tra il valore dell’azione ottimale \(a^*\) e quello dell’azione considerata.
Il regret cumulato può essere espresso come funzione di questi due termini:
\[ L_t = \mathbb{E}\!\left[\sum_{\tau=1}^{t} (V^* - Q(a_\tau))\right] = \sum_{a \in \mathcal{A}} \mathbb{E}[N_t(a)] (V^* - Q(a)) = \sum_{a \in \mathcal{A}} \mathbb{E}[N_t(a)] \, \Delta_a \]
In altre parole, il regret dipende sia dalla frequenza con cui vengono scelte azioni subottimali, sia dall’entità del loro gap rispetto all’azione ottimale.
Un buon algoritmo dovrebbe garantire conteggi \(N_t(a)\) ridotti per le azioni con ampi gap, ossia esplorare poco le scelte chiaramente peggiori.
Tuttavia, il valore esatto dei gap \(\Delta_a\) non è noto a priori, e la capacità di bilanciare correttamente esplorazione e sfruttamento rappresenta quindi la sfida centrale nella progettazione di strategie di apprendimento efficienti.
Difatti, in scenari reali il regret non può essere calcolato esattamente, poiché richiede la conoscenza del valore atteso della vera azione ottimale. Per questo motivo, nella pratica si ricorre a una stima superiore teorica del regret potenziale, che consente di valutare le prestazioni di un algoritmo anche in assenza di conoscenza completa dell’ambiente. Questo approccio è essenziale per analizzare e confrontare algoritmi di apprendimento in qualunque problema di tipo bandit.
Algoritmo \(\epsilon\)-greedy
L’algoritmo \(\epsilon\)-greedy rappresenta una strategia fondamentale per bilanciare esplorazione e sfruttamento nei problemi di multi-armed bandit. Il suo funzionamento si basa su una semplice regola probabilistica:
- con probabilità \(1 - \epsilon\) l’agente sceglie l’azione \(a_t = \arg\max_{a \in \mathcal{A}} \hat{Q}_t(a)\), ossia quella che massimizza il valore stimato della ricompensa, valutata fino al passo t;
- con probabilità \(\epsilon\) seleziona invece un’azione casuale, allo scopo di esplorare nuove possibilità.
Questa combinazione consente di evitare che l’agente si blocchi prematuramente su una politica subottimale, mantenendo un certo grado di esplorazione.
Tuttavia, poiché una frazione \(\epsilon\) delle decisioni sarà sempre casuale, l’algoritmo effettuerà inevitabilmente scelte subottimali per una parte del tempo, bilanciando così in modo controllato accuratezza e scoperta di nuove strategie.
In particolare vediamo che con un \(\epsilon\) fissato, su un orizzonte temporale T , avremo una componente di crescita lineare del regret del tipo \(\sum_a \frac{\epsilon}{|\mathcal A|}T\Delta a\) legata all'esplorazione delle varie azioni.
In pratica, un algoritmo avrà un regret lineare se prende una azione subottimale per una frazione costante del tempo. Circostanza vera sia per gli algoritmi greedy che \(\epsilon\)-greedy.
Regret Bound
Una soluzione può essere prevedere un \(\epsilon\) decrescente, che comprima la fase di esplorazione progressivamente, consentendo di convergere alla soluzione ottimale in modo sublineare.
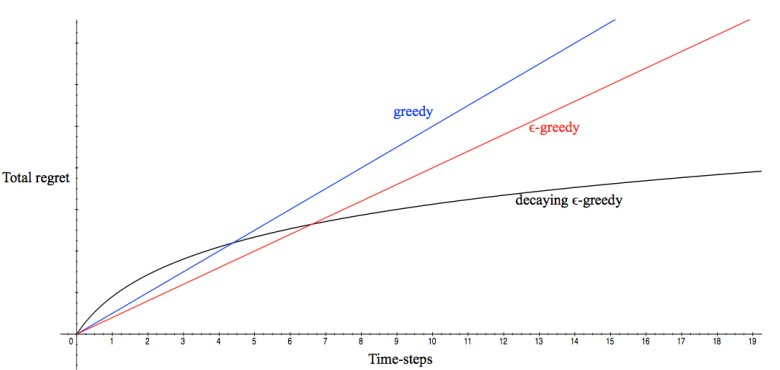
Nel contesto dei multi-armed bandit, i regret bounds rappresentano una misura teorica utile per valutare l’efficienza di un algoritmo nel tempo. Essi descrivono come cresce il regret — ossia la perdita cumulata rispetto alla strategia ottimale — in funzione di determinati parametri del problema o dell’orizzonte temporale.
- Problem independent: questo tipo di limite analizza la crescita del regret come funzione di \(T\), il numero totale di passi temporali. L’obiettivo è ottenere una misura generale, indipendente dalle caratteristiche specifiche delle ricompense o delle azioni, mostrando come il regret si comporti asintoticamente con l’aumentare del tempo.
- Problem dependent: in questo caso il bound tiene conto della struttura del problema, modellando il regret in base al numero di volte in cui ciascun braccio viene selezionato e alla differenza (gap) tra la ricompensa di un’azione subottimale e quella dell’azione ottimale \(a^*\). Questi limiti forniscono una stima più precisa, ma richiedono informazioni dettagliate sull’ambiente.
In sintesi, i problem-independent bounds offrono garanzie generali di robustezza, mentre i problem-dependent bounds permettono analisi più fini e aderenti al comportamento reale dell’algoritmo sul problema.
Il lower bound del regret è uno strumento teorico fondamentale per valutare la difficoltà intrinseca di un problema di multi-armed bandit. Serve a determinare quanto sia complesso per un algoritmo avvicinarsi alla soluzione ottimale, indipendentemente dalla strategia adottata.
Le prestazioni di un algoritmo dipendono dalla similarità tra il braccio ottimale e gli altri bracci disponibili: più le loro distribuzioni di ricompensa sono simili, più difficile sarà distinguere quale azione sia la migliore. Formalmente, questa difficoltà è descritta da:
- il gap \(\Delta_a\), cioè la differenza tra la ricompensa media del braccio ottimale e quella del braccio \(a\);
- la distanza di Kullback-Leibler \(D_{KL}(\mathcal{R}^a \| \mathcal{R}^{a^*})\), che misura la dissimilarità tra le distribuzioni di ricompensa dei due bracci.
Il teorema di Lai e Robbins stabilisce che il regret totale asintotico di qualunque algoritmo è almeno logaritmico rispetto al numero di passi temporali:
\( \lim_{t \to \infty} L_t \geq \log t \sum_{a : \Delta_a > 0} \frac{\Delta_a}{D_{KL}(\mathcal{R}^a \| \mathcal{R}^{a^*})} \)
Questo risultato è significativo perché definisce un limite inferiore teorico — nessun algoritmo può ottenere una crescita del regret più lenta di quella logaritmica. Allo stesso tempo, è promettente notare che tale limite è sublineare: ciò implica che, nel lungo periodo, l’algoritmo apprende e migliora progressivamente le proprie decisioni.
Upper Bounds e stima dell'intervallo superiore di confidenza
L’idea di fondo dell'approccio è di scegliere azioni che potrebbero avere un valore elevato, anche se le informazioni attuali non lo confermano con certezza. Questa filosofia ottimistica è motivata dal fatto che, agendo su bracci incerti ma potenzialmente promettenti, si ottengono sempre due possibili risultati positivi:
- Ottenere una ricompensa elevata: se il braccio esplorato ha effettivamente un’alta ricompensa media, l’agente ne beneficia direttamente.
- Apprendere qualcosa di utile: se invece la ricompensa media è inferiore alle aspettative, il processo di esplorazione consente di ridurre l’incertezza sulla stima del suo valore, migliorando la conoscenza complessiva dell’ambiente.
In questo modo, anche un’azione che non produce un guadagno immediato contribuisce all’obiettivo a lungo termine di ottimizzare le decisioni future, trasformando l’incertezza in informazione.
L’approccio degli Upper Confidence Bounds (UCB) fornisce una strategia sistematica per bilanciare esplorazione e sfruttamento nei multi-armed bandit.
L’idea centrale è di associare a ciascuna azione \(a\) un limite superiore di confidenza \(U_t(a)\), tale che con alta probabilità il valore reale dell’azione soddisfi \(Q(a) \le U_t(a)\).
Questo limite di confidenza dipende dal numero di volte \(N_t(a)\) in cui l’azione è stata selezionata: più un’azione viene esplorata, più l’incertezza sulla sua stima diminuisce, restringendo il suo intervallo di confidenza.
L’algoritmo seleziona quindi, a ogni passo temporale \(t\), l’azione che massimizza il limite superiore \( a_t = \arg\max_{a \in \mathcal{A}} [U_t(a)] \)
In questo modo, le azioni meno esplorate — e quindi più incerte — ricevono un “bonus” che le rende temporaneamente più attraenti. Il metodo UCB incarna così una forma rigorosa di ottimismo nell’incertezza, garantendo nel tempo un trade-off controllato tra esplorazione di nuove opzioni e sfruttamento delle più promettenti.
Il teorema di Hoeffding rappresenta una delle fondamenta matematiche più importanti per la valutazione dell’incertezza nelle stime di media campionaria, un concetto cruciale anche nel Reinforcement Learning. Esso consente di stabilire un limite superiore alla probabilità che la media empirica si discosti in modo significativo dal suo valore atteso, fornendo così una misura di confidenza statistica sui risultati ottenuti da campioni limitati.
Formalmente, data una sequenza di variabili casuali indipendenti e identicamente distribuite \( X_1, X_2, \dots, X_n \in [0,1] \), e la loro media campionaria \( \bar{X}_n = \frac{1}{n} \sum_{\tau=1}^{n} X_\tau \), vale la disuguaglianza:
\( \mathbb{P}(\mathbb{E}[X] - \bar{X}_n > \nu) \le \exp(-2n\nu^2) \) per quanto riguarda una limitazione superiore della stima rispetto alla media reale, oppure
\( \mathbb{P}(|\mathbb{E}[X] - \bar{X}_n| > \nu) \le 2 \exp(-2n\nu^2) \) come intervallo di confidenza della stima rispetto ad \(n\) e \(\nu\)
Da questa relazione si ricava che, con probabilità almeno \(1 - \delta\), la media vera si trova all’interno dell’intervallo:
\( \bar{X}_n - \nu \le \mathbb{E}[X] \le \bar{X}_n + \nu \quad \text{dove} \quad \nu = \sqrt{\frac{\log(2/\delta)}{2n}} \)
Nella pratica si utilizza solo l'estremo superiore, ponendo \( \exp(-2n\nu^2) = \delta ^4\) per convenzione, ottenendo la formulazione dell'algoritmo UCB1
\(\displaystyle a_t=\arg \max_{a\in \mathcal A} \left[ \hat Q(a) + \sqrt {\frac{2 \log {\frac{1}{\delta}}}{N_t(a)}} \right]\)
Il parametro di confidence level \( \delta \) rappresenta la probabilità di errore ammessa quando si costruiscono limiti di confidenza sugli stimatori, come nel caso degli algoritmi basati su Upper Confidence Bounds (UCB). La sua definizione è sottile e strettamente legata al numero di esperimenti o passi temporali del problema considerato.
Quando il numero di passi temporali \( T \) è fissato, si può impostare:
\( \delta = \frac{\tilde{\delta}}{T |\mathcal{A}|} \)
dove \(|\mathcal{A}|\) è il numero di azioni possibili e \(\tilde{\delta}\) rappresenta un livello di confidenza globale prefissato. Questa scelta permette di mantenere il controllo della probabilità complessiva di errore su tutte le iterazioni e su tutte le azioni considerate.
La correzione si basa sulla union bound:
\( P\left( \bigcup_i E_i \right) \leq \sum_i P(E_i) \)
che garantisce che la probabilità complessiva di commettere un errore in almeno uno dei casi non superi la somma delle probabilità dei singoli eventi. Questo approccio è spesso applicato in altri contesti di apprendimento statistico per garantire limiti di confidenza validi anche quando si considerano molteplici decisioni o ipotesi simultanee.
Nel contesto dei multi-armed bandit, il comportamento dell’algoritmo UCB (Upper Confidence Bound) può essere analizzato formalmente attraverso una regret bound, ovvero un limite superiore teorico sul rimpianto cumulativo atteso. L’obiettivo è stimare quante volte un braccio sub-ottimale \( a \neq a^* \) venga selezionato nel tempo, poiché ciò contribuisce direttamente al regret totale.
Per un braccio sub-ottimale, è dimostrabile che il numero atteso di selezioni è limitato da:
\( \mathbb{E}[N_T(a)] \leq \frac{C' \log T}{\Delta_a^2} + \frac{\pi^2}{3} + 1 \)
dove \(\Delta_a = Q(a^*) - Q(a)\) rappresenta il divario di rendimento tra il braccio ottimale e quello considerato. Di conseguenza, il regret complessivo dell’algoritmo UCB è limitato da:
\( R_T \leq \sum_a \Delta_a \, \mathbb{E}[N_T(a)] \leq \sum_a \frac{C' \log T}{\Delta_a} + |\mathcal{A}|\left(\frac{\pi^2}{3} + 1\right) \)
L’analisi si basa su disuguaglianze che legano la stima empirica \(\hat{Q}_t(a)\) al valore atteso reale \(Q(a)\):
- \( Q(a) - \sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \leq \hat{Q}_t(a) \leq Q(a) + \sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \)
- \( Q(a^*) - Q(a) = \Delta_a \leq 2\sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \)
Da quest’ultima relazione segue che il numero di volte in cui un braccio sub-ottimale viene scelto soddisfa:
\( N_t(a) \leq \frac{4 C \log (1/\delta)}{\Delta_a^2} \)
Questo risultato mostra che UCB riesce a limitare in modo logaritmico il numero di esplorazioni non ottimali, ottenendo così un regret sublineare nel tempo. In altre parole, l’algoritmo continua ad esplorare, ma sempre meno frequentemente, garantendo una convergenza progressiva verso la strategia ottimale.
```
In conclusione, la disuguaglianza di Hoeffding fornisce una base teorica per costruire intervalli di confidenza affidabili senza conoscere la distribuzione sottostante, a condizione che le variabili siano indipendenti e limitate. Nel contesto dei multi-armed bandit e del Reinforcement Learning, questa proprietà è essenziale per definire strategie ottimistiche, come gli algoritmi UCB, che bilanciano esplorazione e sfruttamento sulla base di stime statisticamente garantite.
Offline Polict Learning
Sabato, 17 Ottobre 2026 | Reinforcement Learning |
Nel Reinforcement Learning off-policy o Batch RL, l’agente apprende una policy ottimale utilizzando un insieme di dati preesistenti, senza interagire direttamente con l’ambiente. Si parte da un dataset \( \mathcal{D} \) composto da \( n \) traiettorie \( \tau \sim \pi_b \), raccolte da una behavior policy \( \pi_b \) (ad esempio una policy umana o precedente versione dell’agente). Ogni traiettoria contiene sequenze di stati \( s_t \in \mathcal{S} \), azioni \( a_t \in \mathcal{A} \) e ricompense \( r(s_t, a_t) \).
L’obiettivo è stimare o migliorare una nuova policy \( \pi_t(s_t) \to a_t \) a partire da questi dati, valutando controfattualmente cosa accadrebbe se l’agente agisse in modo diverso. Tuttavia, non è possibile semplicemente applicare il Q-learning tradizionale, poiché, pur essendo un algoritmo off-policy, soffre del cosiddetto “deadly triad” — una combinazione pericolosa di tre fattori:
- Bootstrapping: l’aggiornamento del valore dipende da stime precedenti, amplificando eventuali errori.
- Funzione di approssimazione: l’uso di modelli non lineari (es. reti neurali) introduce instabilità.
- Off-policy learning: l’algoritmo apprende da dati generati da una policy diversa, creando divergenze.
Questa interazione può causare instabilità numeriche e fallimenti nella convergenza. Per questo motivo, le tecniche di Batch RL e Counterfactual RL sviluppano varianti più stabili di apprendimento off-policy, capaci di sfruttare dati raccolti in precedenza senza introdurre bias o divergenze.
Offline policy learning and optimization
Nel contesto del Batch Policy Evaluation, l’obiettivo è stimare le prestazioni di una specifica policy decisionale \( \pi \) utilizzando un dataset preesistente di esperienze raccolte da una behavior policy \( \pi_b \). Questo processo è fondamentale nel Reinforcement Learning off-policy, dove non è possibile (o desiderabile) generare nuove interazioni con l’ambiente.
Model based approach
Data una policy \( \pi: s \to a \) e un insieme di traiettorie \( \mathcal{D} = \{\tau_i\}_{i=1}^n \) campionate da \( \pi_b \), si stima il valore atteso di \( \pi \) integrando la funzione di valore stimata \( \hat{V}^\pi(s, \mathcal{D}) \) sugli stati iniziali \( S_0 \):
\( \int_{s \in S_0} \hat{V}^\pi(s, \mathcal{D}) \, ds \)
In questo modo si ottiene una stima del rendimento della policy \( \pi \) senza eseguirla direttamente nell’ambiente, basandosi solo sui dati storici raccolti. Tale approccio è cruciale per valutare politiche candidate in modo sicuro e controllato, specialmente in domini dove la sperimentazione diretta è costosa o rischiosa (come medicina o robotica).
Nel Batch Reinforcement Learning, è possibile stimare le prestazioni di una policy anche senza accedere direttamente all’ambiente, ricostruendo dai dati sia il modello di dynamics che quello di reward. A partire dal dataset di esperienze \( \mathcal{D} \), si apprende una stima del modello di transizione \( \hat{p}(s'|s, a) \) e della funzione di ricompensa \( \hat{r}(s, a) \).
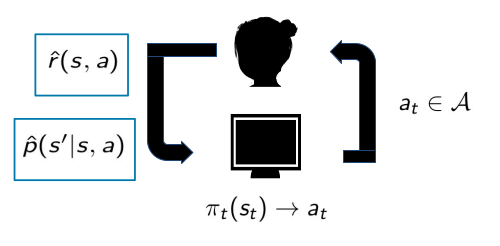
Queste due componenti permettono di derivare una policy stimata \( \hat{\pi}^* \) e di calcolare il valore associato:
\( V^\pi \approx (I - \gamma \hat{P}^\pi)^{-1} \hat{R}^\pi \)
dove \( \hat{P}^\pi(s'|s) = p(s'|s, \pi(s)) \) rappresenta le dinamiche indotte dalla policy, e \( \gamma \) è il fattore di sconto. In alternativa, si può utilizzare il modello appreso per addestrare una nuova policy mediante algoritmi come DQN o altri metodi di RL.
Il valore stimato \( \hat{V}^{\pi^*} \) consente quindi di valutare la policy sulla base del dataset \( \mathcal{D} \), senza ulteriori interazioni con l’ambiente, sfruttando appieno l’informazione implicita nei dati raccolti da una behavior policy precedente.
In pratica si incontra un limite cruciale dell'approccio model-based di dynamics e reward appresi dai dati: anche se un modello risulta accurato nel rappresentare le esperienze passate, potrebbe non generalizzare bene alle situazioni future. Questo fenomeno è noto come bias da errata specificazione del modello (model misspecification). Risultati mostrano che migliorare l’adattamento del modello ai dati osservati non implica necessariamente migliori politiche per scenari futuri. Al contrario, può introdurre distorsioni sistematiche se il modello sottostante è mal specificato.
In sintesi, nella costruzione di modelli per il Reinforcement Learning off-policy o batch, è essenziale bilanciare l’accuratezza rispetto ai dati storici con la capacità di generalizzare a contesti nuovi, evitando che la policy appresa resti vincolata alle limitazioni del modello stesso.
Nel contesto della valutazione off-policy, i modelli utilizzati per stimare le prestazioni di una policy alternativa possono fornire risultati migliori se vengono addestrati con una funzione di perdita diversa da quella usata per la semplice massimizzazione della verosimiglianza. In sintesi, per ottenere una buona valutazione off-policy con un approccio model-based, non basta addestrare modelli accurati sui dati, ma può essere necessario progettare la loss function in funzione del tipo di stima desiderata.
In sintesi, nella costruzione di modelli per il Reinforcement Learning off-policy o batch, è essenziale bilanciare l’accuratezza rispetto ai dati storici con la capacità di generalizzare a contesti nuovi, evitando che la policy appresa resti vincolata alle limitazioni del modello stesso.
Model free methods
L’approccio Model-Free all’apprendimento off-line si basa sulla stima diretta della funzione di valore o della funzione \( Q \), senza la necessità di apprendere un modello esplicito delle dinamiche dell’ambiente. In questo contesto, un metodo molto utilizzato è la Fitted Q Evaluation (FQE), proposta da Ernst et al. (2005).
Si parte da un dataset di esperienze \( \mathcal{D} = \{(s_i, a_i, r_i, s_{i+1})\}_i \), generato da una behavior policy \( \pi_b \). L’obiettivo è stimare la funzione di valore d’azione della policy da valutare \( Q^\pi_\theta(s, a) \).
Per ogni transizione, viene costruito un target supervisionato:
\( \tilde{Q}^\pi(s_i, a_i) = r_i + \gamma V^\pi_\theta(s_{i+1}) \)
Il modello viene quindi aggiornato minimizzando l’errore quadratico medio tra il valore stimato e il target:
\( \arg\min_\theta \sum_i \left(Q^\pi_\theta(s_i, a_i) - \tilde{Q}^\pi(s_i, a_i)\right)^2 \)
Iterando questo processo, si ottiene una stima stabile della funzione \( Q^\pi \) che approssima il valore d’azione per la policy in esame, sfruttando solo i dati già raccolti (off-line). Tra le varianti correlate figurano anche i metodi LSTD (Least Squares Temporal Difference) e le tecniche di regressione iterativa applicate alle funzioni di valore.
In sintesi, l’approccio model-free consente di valutare e migliorare le policy direttamente dai dati, evitando gli errori di modellazione tipici dei metodi model-based, ma richiede una buona copertura dello spazio di stati e azioni nel dataset per garantire stime affidabili.
L’algoritmo di Fitted Q Evaluation (FQE) consente di stimare la funzione di valore d’azione di una policy \( \pi \) utilizzando un dataset statico di transizioni, senza interagire con l’ambiente. È un metodo chiave nell’apprendimento off-line model-free.
Input:
- \( \mathcal{D} = \{(x_i, a_i, x'_i, c_i)\}_{i=1}^n \sim \pi_D \): dataset di transizioni;
- \( \pi \): policy da valutare;
- \( \mathcal{F} \): classe di funzioni (ad esempio una rete neurale profonda).
Algoritmo:
- 1. Inizializza \( Q_0 \in \mathcal{F} \) casualmente.
- 2. Per \( k = 1, 2, \ldots, K \):
- 3. Calcola il target: \( y_i = c_i + \gamma Q_{k-1}(x'_i, \pi(x'_i)) \quad \forall i \)
- 4. Costruisci il set di addestramento: \( \tilde{\mathcal{D}}_k = \{(x_i, a_i, y_i)\}_{i=1}^n \)
- 5. Risolvi un problema di apprendimento supervisionato:
- \( Q_k = \arg\min_{f \in \mathcal{F}} \frac{1}{n} \sum_{i=1}^n (f(x_i, a_i) - y_i)^2 \)
- 6. Fine ciclo.
Output:
\( \hat{Q}^\pi(x) = Q_K(x, \pi(x)) \quad \forall x \)
In pratica, FQE addestra iterativamente una funzione \( Q \) fino alla convergenza, stimando il valore della policy target sui dati raccolti da un’altra policy (behavior policy).
Se si utilizza una DNN come classe di funzioni \( \mathcal{F} \), l’algoritmo diventa analogo al DQN, ma con una differenza cruciale: FQE non interagisce con l’ambiente e aggiorna solo in base ai dati esistenti, mentre DQN genera nuovi campioni online durante l’apprendimento.
La teoria di generalizzazione della Fitted Q Evaluation (FQE) fornisce una stima della quantità di dati necessaria per garantire che la valutazione della policy sia accurata con alta probabilità. In particolare si stabilisce che, dopo \( K \) iterazioni di FQE, la precisione dell’approssimazione dipende dalla numerosità del dataset \( n \).
La condizione sulla dimensione campionaria è:
\( n = O\!\left(\frac{\bar{C}^4}{\varepsilon^2}\!\left(\log\frac{K}{\delta} + \dim\mathcal{F}\log\frac{\bar{C}^2}{\varepsilon^2} + \log\dim\mathcal{F}\right)\right) \)
Il termine \( n \) rappresenta quindi il numero minimo di transizioni necessarie per assicurare, con probabilità almeno \( 1 - \delta \), che la differenza tra il valore stimato \( \hat{V}^\pi(s_0) \) e quello reale \( V^\pi(s_0) \) rimanga entro un margine controllato da \( \varepsilon \).
In termini pratici:
- \( \varepsilon \) indica il livello di accuratezza desiderato — minore è \( \varepsilon \), maggiore deve essere \( n \);
- \( \delta \) controlla la probabilità di errore nella stima (livello di confidenza);
- \( \dim\mathcal{F} \) rappresenta la complessità del modello di apprendimento (ad esempio, la dimensione della rete neurale);
- \( \bar{C} \) e \( d_{\mathcal{F}}^{\pi} \) misurano rispettivamente la stabilità e la capacità di concentrazione della funzione \( Q \) nel dominio della policy target.
In sintesi, il teorema fornisce una garanzia formale sulla generalizzazione della stima ottenuta da FQE: per raggiungere una data precisione \( \varepsilon \) nella valutazione di \( V^\pi \), è necessario un dataset di dimensione \( n \) proporzionale a \( 1 / \varepsilon^2 \) e alla complessità della funzione stimata.
Importance sampling
L’Off-Policy Evaluation (OPE) mira a stimare il valore di una policy target utilizzando dati raccolti da un’altra policy, detta behavior policy, riducendo al minimo le assunzioni sul modello dell’ambiente. L’obiettivo è ottenere una stima affidabile senza dipendere dalla correttezza del modello dinamico né dall’ipotesi di Markov.
In questo contesto, i metodi Monte Carlo rappresentano un punto di partenza utile: essi consentono di stimare aspettative basandosi su campioni empirici, come già avviene per la valutazione online delle policy. Tuttavia, la sfida principale nel caso off-policy è il mismatch di distribuzione dei dati: i dati raccolti dalla policy comportamentale non riflettono necessariamente la distribuzione indotta dalla policy target.
Per affrontare questo problema si utilizza la Importance Sampling (IS), una tecnica statistica che permette di correggere la differenza tra le due distribuzioni tramite un fattore di ponderazione.
L’idea è stimare l’aspettativa di una quantità \( r(x) \) sotto la distribuzione desiderata \( p(x) \) utilizzando campioni estratti da una distribuzione diversa \( q(x) \):
\( \mathbb{E}_p[r] = \sum_x p(x) r(x) = \sum_x q(x) \frac{p(x)}{q(x)} r(x) \approx \frac{1}{N} \sum_{i=1}^N \frac{p(x_i)}{q(x_i)} r(x_i) \)
In questo modo, ogni campione \( x_i \) è pesato in base al rapporto tra la probabilità di osservazione sotto la distribuzione target e quella sotto la distribuzione di comportamento. Questo consente di ottenere una stima non distorta dell’aspettativa reale, a condizione che:
- la distribuzione di campionamento \( q(x) \) copra tutte le regioni dove \( p(x) > 0 \) (proprietà di coverage/overlap);
- non vi siano variabili confondenti nascoste che alterano la relazione tra \( x \), le azioni \( a \) e le ricompense \( r \).
L’Importance Sampling per la valutazione di policy in Reinforcement Learning permette di stimare il valore atteso di una policy target \( \pi \) senza dover conoscere il modello dinamico dell’ambiente. L’idea centrale è riutilizzare traiettorie raccolte da una behavior policy \( \pi_b \), correggendo la differenza di distribuzione tramite pesi di probabilità.
Il valore della policy target è definito come:
\( V^{\pi}(s) = \sum_{\tau} p(\tau \mid \pi, s) R(\tau) \)
Poiché le traiettorie disponibili provengono da \( \pi_b \), possiamo riscrivere:
\( V^{\pi}(s) = \sum_{\tau} p(\tau \mid \pi_b, s) \frac{p(\tau \mid \pi, s)}{p(\tau \mid \pi_b, s)} R_\tau \)
e stimarlo empiricamente con:
\( V^{\pi}(s) \approx \frac{1}{N} \sum_{i=1}^{N} \frac{p(\tau_i \mid \pi, s)}{p(\tau_i \mid \pi_b, s)} R_{\tau_i} \)
Poiché le dinamiche dell’ambiente si annullano nel rapporto, i pesi si riducono ai soli rapporti tra probabilità di azioni sotto le due policy:
\( \frac{p(\tau_i \mid \pi, s)}{p(\tau_i \mid \pi_b, s)} = \prod_{t=1}^{H_i} \frac{p(a_{it} \mid s_{it}, \pi)}{p(a_{it} \mid s_{it}, \pi_b)} \)
Quindi, la stima finale del valore atteso della policy target diventa:
\( V^{\pi}(s) \approx \sum_{i=1}^{N} R_{\tau_i} \prod_{t=1}^{H_i} \frac{p(a_{it} \mid s_{it}, \pi)}{p(a_{it} \mid s_{it}, \pi_b)} \)
In sintesi, l’importance sampling in RL consente di valutare una policy senza conoscere le transizioni \( p(s' \mid s, a) \), basandosi solo sui rapporti di probabilità delle azioni tra policy target e behavior policy. Questo approccio è quindi model-free e particolarmente utile in contesti off-policy, dove l’interazione diretta con l’ambiente non è possibile. Questo approccio pertanto non richiede l'assunzione di Markov, è unbiased, simile all'approccio Monte Carlo ma con la correzione del mismatch tra le distribuzioni.
Il Per-Decision Importance Sampling (PDIS) è una variante dell’importance sampling progettata per la valutazione di policy in Reinforcement Learning, che sfrutta la struttura temporale delle traiettorie per ridurre la varianza della stima. L’idea di base è simile a quella dei policy gradient methods: invece di pesare un’intera traiettoria con un unico fattore di probabilità cumulativo, PDIS applica una correzione passo per passo.
La stima classica dell’importance sampling sull’intero dataset \( D \) è data da:
\( IS(D) = \frac{1}{n} \sum_{i=1}^{n} \left( \prod_{t=1}^{L} \frac{\pi_e(a_t \mid s_t)}{\pi_b(a_t \mid s_t)} \right) \left( \sum_{t=1}^{L} \gamma^t R_t^i \right) \)
dove ogni traiettoria è ponderata in base al prodotto dei rapporti di probabilità tra la policy target \( \pi_e \) (evaluation policy) e la policy comportamentale \( \pi_b \) lungo tutti i passi temporali \( t \).
Il Per-State Importance Sampling (PSIS o PDIS) migliora questa formulazione pesando le ricompense parziali passo per passo:
\( PSID(D) = \sum_{t=1}^{L} \gamma^t \frac{1}{n} \sum_{i=1}^{n} \left( \prod_{\tau=1}^{t} \frac{\pi_e(a_\tau \mid s_\tau)}{\pi_b(a_\tau \mid s_\tau)} \right) R_t^i \)
In questo modo, la correzione di importanza viene applicata fino al tempo \( t \) invece che su tutta la traiettoria, permettendo di:
- sfruttare la struttura temporale del dominio (le ricompense dipendono dal tempo);
- ridurre la varianza della stima, particolarmente elevata nel caso standard di IS cumulativo;
- ottenere stime più stabili e più simili a quelle basate su metodi Monte Carlo passo per passo.
Il PDIS rappresenta quindi un compromesso efficace tra accuratezza e stabilità statistica, mantenendo la proprietà di non distorsione dell’IS, ma migliorando la sua efficienza pratica nel contesto di policy evaluation off-policy.
In generale IS e PSID soffrono di alta varianza, specie con orizzonti lunghi, per cui possono essere adottate misure per contrastare il fenomeno, esplicitando l'assunzione di Markov od utilizzando correttivi.
Off-Policy Optimization
Fino al 2020, la Offline Policy Optimization (OPO) — ovvero l’ottimizzazione di policy in ambienti offline — si è basata su un presupposto cruciale: la presenza di overlap tra le distribuzioni delle policy. Questo significa che, nei dataset di esperienza utilizzati per l’addestramento, ogni azione considerata dalla policy target deve essere stata osservata almeno in alcune circostanze dalla policy comportamentale.
In particolare:
- Off-policy estimation: richiede overlap per la sola policy di interesse, al fine di stimarne correttamente il valore atteso.
- Off-policy optimization: richiede overlap per tutte le policy potenzialmente ottimali, ipotesi nota come concentrability assumption nel contesto del batch reinforcement learning.
Tuttavia, questo presupposto è poco realistico in molti scenari pratici. Gran parte dei dataset reali non deriva da esplorazioni casuali o complete dello spazio di stati e azioni: spesso i dati riflettono soltanto le decisioni prese da un singolo sistema o esperto.
Quando si assume overlap dove in realtà non esiste, si rischia di:
- stimare in modo eccessivamente ottimistico le prestazioni di una policy;
- ottenere un comportamento che appare performante in fase di addestramento, ma che fallisce una volta implementato nel mondo reale.
In sintesi, la ricerca successiva ha riconosciuto che la mancanza di overlap rappresenta uno dei principali ostacoli alla robustezza e generalizzazione delle policy apprese in contesti di offline reinforcement learning.
La Off-Policy Optimization senza piena copertura dei dati rappresenta un’evoluzione del Reinforcement Learning offline, nata per affrontare la mancanza di overlap tra le distribuzioni di comportamento e quelle target. Quando il dataset non copre l’intero spazio di stati e azioni, le stime di valore possono diventare instabili o fuorvianti. L’obiettivo è quindi “fare il meglio possibile con i dati disponibili”.
Le strategie principali adottate sono:
- Limitare l’ottimizzazione off-policy solo alle regioni dello spazio \( (s, a) \) dove esiste effettivo overlap nei dati. Questa idea richiama tecniche già note come i vincoli KL e il PPO clipping, che impediscono deviazioni eccessive dalla policy di riferimento.
- Adottare algoritmi computazionalmente trattabili, che possano stimare e penalizzare le regioni scarsamente supportate senza introdurre complessità eccessiva.
- Applicare un approccio pessimistico nelle aree con scarso supporto: in assenza di dati sufficienti, si assume che gli esiti possano essere sfavorevoli, riducendo così il rischio di sovrastimare il valore atteso di certe azioni.
Questa linea di ricerca mira a fornire una risposta al problema del data coverage limitato nell’apprendimento da dati offline.
Il metodo Marginalized Behavior Supported (MBI) Policy Optimization introduce una strategia per gestire l’ottimizzazione di policy in contesti offline dove il supporto dei dati è limitato. L’idea chiave è quella di considerare solo le azioni che hanno una sufficiente probabilità di essere state osservate nella policy comportamentale, evitando di stimare valori in regioni dello spazio \( (s, a) \) scarsamente rappresentate.
Il meccanismo si basa su una filtrazione comportamentale espressa tramite una funzione indicatrice:
\( \zeta(s, a; \hat{\mu}, b) = 1(\hat{\mu}(s, a) > b) \)
dove:
- \( \hat{\mu}(s, a) \) rappresenta la probabilità stimata che l’azione \( a \) sia stata scelta nello stato \( s \) secondo la policy comportamentale;
- \( b \) è una soglia di confidenza che determina il livello minimo di supporto richiesto per considerare l’azione affidabile.
Questa funzione filtra le azioni poco rappresentate, garantendo che le valutazioni si basino solo su esperienze realmente supportate dai dati.
Sulla base di questo filtro, vengono definite due versioni modificate dell’operatore di Bellman:
- Bellman operator:
\( \mathcal{T}f(s,a) = r(s,a) + \gamma \, \mathbb{E}_{s'}\left[\max_{a'} \zeta(s', a') f(s', a')\right] \)
- Bellman evaluation operator:
\( \mathcal{T}^{\pi}f(s,a) = r(s,a) + \gamma \, \mathbb{E}_{s',a' \sim P,\pi}\left[\zeta(s', a') f(s', a')\right] \)
In queste formulazioni, l’operatore \( \zeta(s', a') \) agisce come un filtro che riduce o annulla il contributo delle coppie stato–azione non sufficientemente supportate. Questo approccio permette di mantenere stabilità e coerenza nelle stime del valore, migliorando la robustezza delle policy apprese in scenari con dati parziali o distribuzioni comportamentali sbilanciate.
