Multi-Armed Bandit (MAB)
Domenica, 25 Ottobre 2026 | Reinforcement Learning |
Il problema dei multi-armed bandits rappresenta una delle formulazioni fondamentali del reinforcement learning, in cui un agente deve scegliere tra diverse azioni, dette “braccia” (arms), per massimizzare la ricompensa cumulata nel tempo. Formalmente, un bandit è descritto da una coppia \((\mathcal{A}, \mathcal{R})\), dove:
- \(\mathcal{A}\) è l’insieme noto di \(m\) azioni possibili;
- \(\mathcal{R}^a(r) = \mathbb{P}[r \mid a]\) rappresenta la distribuzione di probabilità, sconosciuta, dei reward associati a ciascuna azione.
A ogni passo temporale \(t\), l’agente seleziona un’azione \(a_t \in \mathcal{A}\) e riceve una ricompensa \(r_t \sim \mathcal{R}^{a_t}\) generato dall’ambiente. L’obiettivo dell’agente è massimizzare la ricompensa cumulata nel tempo, cioè: \(\sum_{\tau=1}^{t} r_\tau\). Questo scenario illustra in modo semplice ma potente il compromesso fondamentale del reinforcement learning tra esplorazione (scoprire nuove azioni potenzialmente migliori) ed exploitation (sfruttare le azioni già note come vantaggiose).
Algoritmo Greedy
L’algoritmo greedy rappresenta una strategia fondamentale nei problemi di multi-armed bandit, basata sulla scelta dell’azione con il valore stimato più alto in ogni passo temporale. Gli algoritmi di questo tipo stimano il valore atteso di ciascuna azione \(a\) come: \(\hat{Q}_t(a) \approx Q(a) = \mathbb{E}[R(a)]\), dove \(\mathbb{E}[R(a)]\) è la ricompensa media attesa associata a quell’azione.
Il valore di ogni azione viene calcolato tramite una stima Monte Carlo: \[ \hat{Q}_t(a) = \frac{1}{N_t(a)} \sum_{i=1}^{t-1} r_i \, \mathbf{1}(a_i = a) \] dove \(N_t(a)\) è il numero di volte in cui l’azione \(a\) è stata selezionata fino al tempo \(t\), e \(r_i\) rappresenta la ricompensa osservata.
Il principio greedy consiste quindi nel selezionare, a ogni iterazione, l’azione con il valore stimato più alto: \[ a_t^* = \arg\max_{a \in \mathcal{A}} \hat{Q}_t(a) \] Questa strategia massimizza l’utilizzo delle informazioni note (exploitation), ma ignora la possibilità di esplorare nuove azioni che potrebbero portare a ricompense migliori in futuro. Di conseguenza, l’algoritmo greedy può convergere rapidamente, ma rischia di rimanere bloccato in soluzioni subottimali.
Regret e valutazione dei MAB
Nel contesto dei multi-armed bandits, la quantità di regret è una misura strutturata delle performance dell’agente, che quantifica quanto lo stesso avrebbe potuto guadagnare se avesse sempre scelto l’azione ottimale.
Si definisce infatti il valore ottimale \(V^* = \max_{a \in \mathcal{A}} Q(a)\), dove \(Q(a) = \mathbb{E}[r\mid a]\) è il valore atteso dell’azione \(a\).
Per ogni passo \(t\), il regret istantaneo è dato da \(l_t = \mathbb{E}\big[V^* - Q(a_t)\big]\), mentre il regret cumulato fino al tempo \(t\) è \(L_t = \mathbb{E}\big[\sum_{\tau=1}^t \big(V^* - Q(a_\tau)\big)\big]\).
Minimizzare il regret cumulato equivale, in uno scenario di bandit, a massimizzare la ricompensa cumulativa, e pertanto l’analisi del regret fornisce un criterio formale per valutare e confrontare algoritmi in termini di efficienza e rapidità di apprendimento.
La valutazione del regret nei problemi di multi-armed bandit consente quindi di quantificare come la politica di selezione delle azioni si discosti da quella ottimale.
Per ogni azione \(a\) si definisce \(N_t(a)\) come il numero di volte in cui l’azione è stata selezionata fino al tempo \(t\), e si introduce il gap \(\Delta_a = V^* - Q(a)\), ossia la differenza tra il valore dell’azione ottimale \(a^*\) e quello dell’azione considerata.
Il regret cumulato può essere espresso come funzione di questi due termini:
\[ L_t = \mathbb{E}\!\left[\sum_{\tau=1}^{t} (V^* - Q(a_\tau))\right] = \sum_{a \in \mathcal{A}} \mathbb{E}[N_t(a)] (V^* - Q(a)) = \sum_{a \in \mathcal{A}} \mathbb{E}[N_t(a)] \, \Delta_a \]
In altre parole, il regret dipende sia dalla frequenza con cui vengono scelte azioni subottimali, sia dall’entità del loro gap rispetto all’azione ottimale.
Un buon algoritmo dovrebbe garantire conteggi \(N_t(a)\) ridotti per le azioni con ampi gap, ossia esplorare poco le scelte chiaramente peggiori.
Tuttavia, il valore esatto dei gap \(\Delta_a\) non è noto a priori, e la capacità di bilanciare correttamente esplorazione e sfruttamento rappresenta quindi la sfida centrale nella progettazione di strategie di apprendimento efficienti.
Difatti, in scenari reali il regret non può essere calcolato esattamente, poiché richiede la conoscenza del valore atteso della vera azione ottimale. Per questo motivo, nella pratica si ricorre a una stima superiore teorica del regret potenziale, che consente di valutare le prestazioni di un algoritmo anche in assenza di conoscenza completa dell’ambiente. Questo approccio è essenziale per analizzare e confrontare algoritmi di apprendimento in qualunque problema di tipo bandit.
Algoritmo \(\epsilon\)-greedy
L’algoritmo \(\epsilon\)-greedy rappresenta una strategia fondamentale per bilanciare esplorazione e sfruttamento nei problemi di multi-armed bandit. Il suo funzionamento si basa su una semplice regola probabilistica:
- con probabilità \(1 - \epsilon\) l’agente sceglie l’azione \(a_t = \arg\max_{a \in \mathcal{A}} \hat{Q}_t(a)\), ossia quella che massimizza il valore stimato della ricompensa, valutata fino al passo t;
- con probabilità \(\epsilon\) seleziona invece un’azione casuale, allo scopo di esplorare nuove possibilità.
Questa combinazione consente di evitare che l’agente si blocchi prematuramente su una politica subottimale, mantenendo un certo grado di esplorazione.
Tuttavia, poiché una frazione \(\epsilon\) delle decisioni sarà sempre casuale, l’algoritmo effettuerà inevitabilmente scelte subottimali per una parte del tempo, bilanciando così in modo controllato accuratezza e scoperta di nuove strategie.
In particolare vediamo che con un \(\epsilon\) fissato, su un orizzonte temporale T , avremo una componente di crescita lineare del regret del tipo \(\sum_a \frac{\epsilon}{|\mathcal A|}T\Delta a\) legata all'esplorazione delle varie azioni.
In pratica, un algoritmo avrà un regret lineare se prende una azione subottimale per una frazione costante del tempo. Circostanza vera sia per gli algoritmi greedy che \(\epsilon\)-greedy.
Regret Bound
Una soluzione può essere prevedere un \(\epsilon\) decrescente, che comprima la fase di esplorazione progressivamente, consentendo di convergere alla soluzione ottimale in modo sublineare.
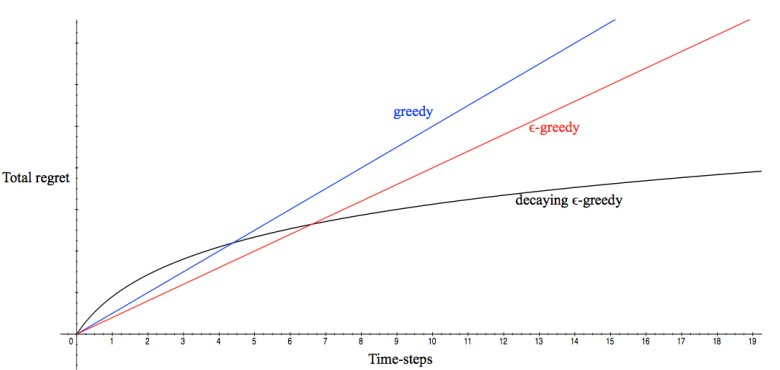
Nel contesto dei multi-armed bandit, i regret bounds rappresentano una misura teorica utile per valutare l’efficienza di un algoritmo nel tempo. Essi descrivono come cresce il regret — ossia la perdita cumulata rispetto alla strategia ottimale — in funzione di determinati parametri del problema o dell’orizzonte temporale.
- Problem independent: questo tipo di limite analizza la crescita del regret come funzione di \(T\), il numero totale di passi temporali. L’obiettivo è ottenere una misura generale, indipendente dalle caratteristiche specifiche delle ricompense o delle azioni, mostrando come il regret si comporti asintoticamente con l’aumentare del tempo.
- Problem dependent: in questo caso il bound tiene conto della struttura del problema, modellando il regret in base al numero di volte in cui ciascun braccio viene selezionato e alla differenza (gap) tra la ricompensa di un’azione subottimale e quella dell’azione ottimale \(a^*\). Questi limiti forniscono una stima più precisa, ma richiedono informazioni dettagliate sull’ambiente.
In sintesi, i problem-independent bounds offrono garanzie generali di robustezza, mentre i problem-dependent bounds permettono analisi più fini e aderenti al comportamento reale dell’algoritmo sul problema.
Il lower bound del regret è uno strumento teorico fondamentale per valutare la difficoltà intrinseca di un problema di multi-armed bandit. Serve a determinare quanto sia complesso per un algoritmo avvicinarsi alla soluzione ottimale, indipendentemente dalla strategia adottata.
Le prestazioni di un algoritmo dipendono dalla similarità tra il braccio ottimale e gli altri bracci disponibili: più le loro distribuzioni di ricompensa sono simili, più difficile sarà distinguere quale azione sia la migliore. Formalmente, questa difficoltà è descritta da:
- il gap \(\Delta_a\), cioè la differenza tra la ricompensa media del braccio ottimale e quella del braccio \(a\);
- la distanza di Kullback-Leibler \(D_{KL}(\mathcal{R}^a \| \mathcal{R}^{a^*})\), che misura la dissimilarità tra le distribuzioni di ricompensa dei due bracci.
Il teorema di Lai e Robbins stabilisce che il regret totale asintotico di qualunque algoritmo è almeno logaritmico rispetto al numero di passi temporali:
\( \lim_{t \to \infty} L_t \geq \log t \sum_{a : \Delta_a > 0} \frac{\Delta_a}{D_{KL}(\mathcal{R}^a \| \mathcal{R}^{a^*})} \)
Questo risultato è significativo perché definisce un limite inferiore teorico — nessun algoritmo può ottenere una crescita del regret più lenta di quella logaritmica. Allo stesso tempo, è promettente notare che tale limite è sublineare: ciò implica che, nel lungo periodo, l’algoritmo apprende e migliora progressivamente le proprie decisioni.
Upper Bounds e stima dell'intervallo superiore di confidenza
L’idea di fondo dell'approccio è di scegliere azioni che potrebbero avere un valore elevato, anche se le informazioni attuali non lo confermano con certezza. Questa filosofia ottimistica è motivata dal fatto che, agendo su bracci incerti ma potenzialmente promettenti, si ottengono sempre due possibili risultati positivi:
- Ottenere una ricompensa elevata: se il braccio esplorato ha effettivamente un’alta ricompensa media, l’agente ne beneficia direttamente.
- Apprendere qualcosa di utile: se invece la ricompensa media è inferiore alle aspettative, il processo di esplorazione consente di ridurre l’incertezza sulla stima del suo valore, migliorando la conoscenza complessiva dell’ambiente.
In questo modo, anche un’azione che non produce un guadagno immediato contribuisce all’obiettivo a lungo termine di ottimizzare le decisioni future, trasformando l’incertezza in informazione.
L’approccio degli Upper Confidence Bounds (UCB) fornisce una strategia sistematica per bilanciare esplorazione e sfruttamento nei multi-armed bandit.
L’idea centrale è di associare a ciascuna azione \(a\) un limite superiore di confidenza \(U_t(a)\), tale che con alta probabilità il valore reale dell’azione soddisfi \(Q(a) \le U_t(a)\).
Questo limite di confidenza dipende dal numero di volte \(N_t(a)\) in cui l’azione è stata selezionata: più un’azione viene esplorata, più l’incertezza sulla sua stima diminuisce, restringendo il suo intervallo di confidenza.
L’algoritmo seleziona quindi, a ogni passo temporale \(t\), l’azione che massimizza il limite superiore \( a_t = \arg\max_{a \in \mathcal{A}} [U_t(a)] \)
In questo modo, le azioni meno esplorate — e quindi più incerte — ricevono un “bonus” che le rende temporaneamente più attraenti. Il metodo UCB incarna così una forma rigorosa di ottimismo nell’incertezza, garantendo nel tempo un trade-off controllato tra esplorazione di nuove opzioni e sfruttamento delle più promettenti.
Il teorema di Hoeffding rappresenta una delle fondamenta matematiche più importanti per la valutazione dell’incertezza nelle stime di media campionaria, un concetto cruciale anche nel Reinforcement Learning. Esso consente di stabilire un limite superiore alla probabilità che la media empirica si discosti in modo significativo dal suo valore atteso, fornendo così una misura di confidenza statistica sui risultati ottenuti da campioni limitati.
Formalmente, data una sequenza di variabili casuali indipendenti e identicamente distribuite \( X_1, X_2, \dots, X_n \in [0,1] \), e la loro media campionaria \( \bar{X}_n = \frac{1}{n} \sum_{\tau=1}^{n} X_\tau \), vale la disuguaglianza:
\( \mathbb{P}(\mathbb{E}[X] - \bar{X}_n > \nu) \le \exp(-2n\nu^2) \) per quanto riguarda una limitazione superiore della stima rispetto alla media reale, oppure
\( \mathbb{P}(|\mathbb{E}[X] - \bar{X}_n| > \nu) \le 2 \exp(-2n\nu^2) \) come intervallo di confidenza della stima rispetto ad \(n\) e \(\nu\)
Da questa relazione si ricava che, con probabilità almeno \(1 - \delta\), la media vera si trova all’interno dell’intervallo:
\( \bar{X}_n - \nu \le \mathbb{E}[X] \le \bar{X}_n + \nu \quad \text{dove} \quad \nu = \sqrt{\frac{\log(2/\delta)}{2n}} \)
Nella pratica si utilizza solo l'estremo superiore, ponendo \( \exp(-2n\nu^2) = \delta ^4\) per convenzione, ottenendo la formulazione dell'algoritmo UCB1
\(\displaystyle a_t=\arg \max_{a\in \mathcal A} \left[ \hat Q(a) + \sqrt {\frac{2 \log {\frac{1}{\delta}}}{N_t(a)}} \right]\)
Il parametro di confidence level \( \delta \) rappresenta la probabilità di errore ammessa quando si costruiscono limiti di confidenza sugli stimatori, come nel caso degli algoritmi basati su Upper Confidence Bounds (UCB). La sua definizione è sottile e strettamente legata al numero di esperimenti o passi temporali del problema considerato.
Quando il numero di passi temporali \( T \) è fissato, si può impostare:
\( \delta = \frac{\tilde{\delta}}{T |\mathcal{A}|} \)
dove \(|\mathcal{A}|\) è il numero di azioni possibili e \(\tilde{\delta}\) rappresenta un livello di confidenza globale prefissato. Questa scelta permette di mantenere il controllo della probabilità complessiva di errore su tutte le iterazioni e su tutte le azioni considerate.
La correzione si basa sulla union bound:
\( P\left( \bigcup_i E_i \right) \leq \sum_i P(E_i) \)
che garantisce che la probabilità complessiva di commettere un errore in almeno uno dei casi non superi la somma delle probabilità dei singoli eventi. Questo approccio è spesso applicato in altri contesti di apprendimento statistico per garantire limiti di confidenza validi anche quando si considerano molteplici decisioni o ipotesi simultanee.
Nel contesto dei multi-armed bandit, il comportamento dell’algoritmo UCB (Upper Confidence Bound) può essere analizzato formalmente attraverso una regret bound, ovvero un limite superiore teorico sul rimpianto cumulativo atteso. L’obiettivo è stimare quante volte un braccio sub-ottimale \( a \neq a^* \) venga selezionato nel tempo, poiché ciò contribuisce direttamente al regret totale.
Per un braccio sub-ottimale, è dimostrabile che il numero atteso di selezioni è limitato da:
\( \mathbb{E}[N_T(a)] \leq \frac{C' \log T}{\Delta_a^2} + \frac{\pi^2}{3} + 1 \)
dove \(\Delta_a = Q(a^*) - Q(a)\) rappresenta il divario di rendimento tra il braccio ottimale e quello considerato. Di conseguenza, il regret complessivo dell’algoritmo UCB è limitato da:
\( R_T \leq \sum_a \Delta_a \, \mathbb{E}[N_T(a)] \leq \sum_a \frac{C' \log T}{\Delta_a} + |\mathcal{A}|\left(\frac{\pi^2}{3} + 1\right) \)
L’analisi si basa su disuguaglianze che legano la stima empirica \(\hat{Q}_t(a)\) al valore atteso reale \(Q(a)\):
- \( Q(a) - \sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \leq \hat{Q}_t(a) \leq Q(a) + \sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \)
- \( Q(a^*) - Q(a) = \Delta_a \leq 2\sqrt{\frac{C \log (1/\delta)}{N_t(a)}} \)
Da quest’ultima relazione segue che il numero di volte in cui un braccio sub-ottimale viene scelto soddisfa:
\( N_t(a) \leq \frac{4 C \log (1/\delta)}{\Delta_a^2} \)
Questo risultato mostra che UCB riesce a limitare in modo logaritmico il numero di esplorazioni non ottimali, ottenendo così un regret sublineare nel tempo. In altre parole, l’algoritmo continua ad esplorare, ma sempre meno frequentemente, garantendo una convergenza progressiva verso la strategia ottimale.
```
In conclusione, la disuguaglianza di Hoeffding fornisce una base teorica per costruire intervalli di confidenza affidabili senza conoscere la distribuzione sottostante, a condizione che le variabili siano indipendenti e limitate. Nel contesto dei multi-armed bandit e del Reinforcement Learning, questa proprietà è essenziale per definire strategie ottimistiche, come gli algoritmi UCB, che bilanciano esplorazione e sfruttamento sulla base di stime statisticamente garantite.
